Richard Ho, quien ayudó a crear el primer chip TPU de Google, construyó la unidad de semiconductores de OpenAI desde cero. Ahora se enfrenta al despliegue de sus primeros chips, al pesimismo generalizado y a la "competencia entre amigos" con Nvidia.
Hace dos años, poco después de que Richard Ho, vicepresidente de hardware de OpenAI, se uniera al gigante de la IA, viajó a Asia con el director ejecutivo Sam Altman y un grupo de investigadores para reunirse con los mayores fabricantes de chips del mundo: TSMC, Samsung y SK Hynix.
El mensaje de Altman fue directo. La ya insaciable demanda de potencia informática de OpenAI no haría más que crecer, y la industria de los semiconductores tenía que acelerar el ritmo, mucho más rápido. «Miren, en unos años vamos a necesitar mucho más silicio», recuerda Ho que les dijo Altman. «Por favor, empiecen a construir más fábricas».
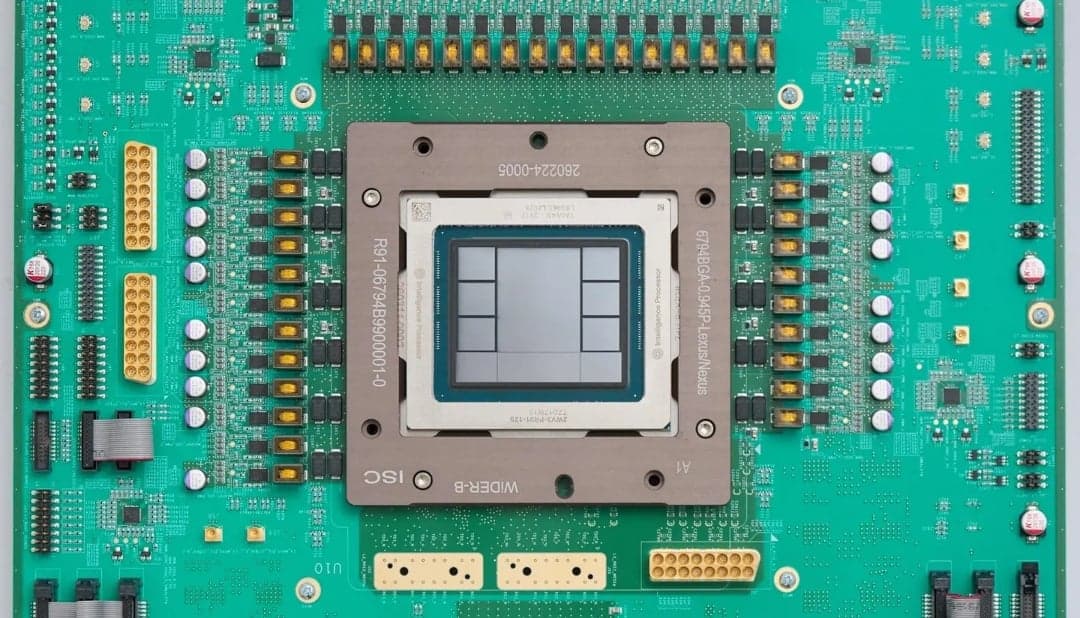
Esas empresas construyeron más fábricas, las plantas de fabricación donde se ensamblan físicamente los chips de computadora. Pero no fue suficiente para satisfacer la insaciable demanda de OpenAI, según Ho declaró a Forbes . Fue en parte debido a esa presión que OpenAI decidió construir su propio hardware, y Altman contactó a Ho para formar un equipo desde cero. Dos años después, la compañía anunció su primer semiconductor, un chip de inferencia llamado Jalapeno. En junio, OpenAI anunció que había construido el chip en nueve meses y que planeaba comenzar a distribuirlo en centros de datos para finales de año.
“Una de las limitaciones a las que nos enfrentamos ahora es que si hubiéramos empezado a construir [más fábricas] hace dos años y medio, estaríamos en una posición mucho mejor”, declara Ho a Forbes .
Antes de unirse a OpenAI, Ho, veterano de Google, ayudó a diseñar el primer chip TPU del gigante de las búsquedas, un silicio personalizado diseñado específicamente para la inteligencia artificial. Conversó extensamente con Forbes , donde habló sobre la creación del equipo, la elección de Broadcom como socio de semiconductores en lugar de Nvidia y AMD, y cómo el debate sobre el pesimismo ha influido en su trabajo de diseño de chips. Esta transcripción ha sido editada para mayor brevedad y claridad.
Richard Nieva: Empezaré con una pregunta sencilla: ¿Por qué se llama Jalapeño a esta patata frita?
Richard Ho: No nos tomamos las cosas demasiado en serio. Estábamos en la cafetería de la oficina y hay una barra de especias con todas las salsas, y nuestro equipo siempre se siente atraído por ella. De hecho, nuestro equipo se llama Hot Peppers. Nos pusimos ese nombre por eso. Así que nos pareció natural nombrar nuestro dispositivo y nuestro proyecto con algo que nos encanta: la comida picante.
Nieva: ¿Por qué OpenAI necesita construir un chip?

Cortesía de OpenAI
Ho: Creo que se trata de controlar toda la infraestructura. Obviamente, OpenAI tiene los modelos, los gestiona bien y cuenta con el software necesario para extraer la información de los modelos y llevarla hasta los chips, que hasta ahora han sido principalmente GPU. Si podemos controlar la infraestructura, podemos hacer más y mejor. Si controlamos nuestros centros de datos, los chips, los sistemas que los integran, el modelo y el software, podemos ser más eficientes. En lugar de tener una interfaz rígida en cada capa, podemos fusionar y reorganizar elementos para mejorar la eficiencia. Esto, en última instancia, se traduce en mayor inteligencia con menor consumo energético para el usuario, que es nuestra métrica clave: ¿con qué eficiencia podemos ofrecer inteligencia por vatio de energía consumida?
Nieva: Fabricar un chip propio es un proceso costoso y laborioso. ¿Podrías contarme cómo surgió la idea? ¿Cómo fueron esas conversaciones y qué te dijo Sam Altman?
Ho: Mis conversaciones iniciales con él fueron algo así como: “¿Queremos construir nuestro propio dispositivo?”. No era algo obvio. Era más bien: veamos qué opciones tenemos. ¿Podemos conseguir lo que necesitamos pidiéndoles a los proveedores existentes —AMD, Nvidia, Intel— que hagan algo que nos interese? Y resultó que, debido a que tienen un mercado muy general, fue muy difícil obtener exactamente lo que queríamos de ellos. Y tenían arquitecturas heredadas que debían preservar. Y lo que decidimos —y lo que vimos después de hacer ese análisis tan objetivo— fue que si adoptábamos un enfoque de diseño completamente nuevo para crear un chip para esto, sería mucho más eficiente que cualquier cosa construida sobre una arquitectura heredada. Y fue entonces cuando Sam básicamente nos permitió decir: “De acuerdo, empecemos”.
Íbamos a formar un equipo pequeño. No íbamos a crear un equipo del tamaño de Intel ni siquiera de Nvidia, pero ¿podríamos lograr algo con un equipo pequeño y de élite, utilizando nuestra propia IA para acelerar el proceso y obtener buenos resultados? En aquel entonces, a principios de 2024, cuando empezamos a hablar de esto, los modelos no eran muy buenos en cuanto a hardware, para ser sinceros. Así que teníamos algunas dudas sobre cuánto beneficio nos aportarían. Pero a lo largo de los meses y el año siguientes, los modelos mejoraron mucho, y logramos obtener grandes beneficios al utilizarlos para acelerar el proceso.
Nieva: Dijiste que es un equipo pequeño. ¿De qué tamaño es exactamente?
Ho: Son unas 100 personas. Pero durante este proceso, el promedio era de unas 70. [En comparación con los equipos de Nvidia o Intel, que pueden llegar a tener 500 personas o más.] Pero no se trata solo de gente que trabaja con chips. Es todo el sistema: rack, diseño de placas, alimentación, gestión térmica, software de la cadena de suministro. Así que, en términos de la cantidad de personas que trabajan con chips, es al menos dos órdenes de magnitud menor que un equipo típico de chips.
Nieva: Cuando hablas de eficiencia, ¿te refieres a que está adaptada específicamente a tu carga de trabajo?
Ho: Es un chip muy flexible y programable. No es específico para los modelos de OpenAI. Puede procesar casi cualquier modelo, y eso es importante porque, a medida que los investigadores siguen trabajando en él y vemos que los modelos mejoran cada vez más, necesitamos un sistema que se adapte fácilmente a los cambios que ellos mismos propongan. De esta forma, cuando desarrollemos modelos futuros, este hardware seguirá siendo muy eficiente para ejecutarlos. Ese era un objetivo de diseño fundamental, y creo que lo hemos logrado con los resultados que hemos presentado aquí.
Nieva: ¿Por qué decidiste optar por esa vía de inferencia más general? OpenAI es una empresa que requiere mucha capacidad de procesamiento. ¿Por qué no adaptarla mejor a tus necesidades específicas?
Ho: Aquí es donde me pongo en la piel de un experto en hardware. El hardware lleva mucho tiempo, ¿verdad? Dijimos que tardamos nueve meses, y ese es uno de los procesos más rápidos, si no el más rápido, para pasar del diseño inicial (o incluso sin diseño) a la fabricación de un dispositivo. Pero incluso nueve meses en el mundo de la IA es mucho tiempo. Y aún nos lleva tiempo implementarlo en los centros de datos y desplegarlo. Por lo tanto, cualquier hardware que se instale debe ser adaptable y estar listo para evolucionar con mejores modelos y nuevas ideas que surgen constantemente en el mundo de la investigación en IA.
Como experto en hardware, crear algo muy específico da mucho miedo, porque cada semana te encuentras con la constante preocupación de: ¿Cuál es la investigación más reciente? ¿Cuál es el último artículo publicado? ¿Podemos adaptarnos? Al crear un dispositivo más programable y de propósito general, tienes la tranquilidad de saber que puedes adaptarte. Dicho esto, es un poco más especializado que una GPU estándar, que es muy programable en todos los sentidos. Nosotros nos especializamos en transformadores y LLM. Dentro de esa categoría de dispositivos, deberíamos ser muy adaptables. Pero si nos dedicamos a otras cosas, quizás haya un hardware mejor para ello.
Nieva: Con semejante capacidad de inferencia general, ¿forma parte del plan vender los chips a otras empresas o alquilarlos a través de la nube?
Ho: No vamos a descartar esa posibilidad, pero tenemos tanta demanda interna que nos llevará un tiempo satisfacerla. Dado que es un producto tan intercambiable, creo que vale la pena hablar de ello, pero no es algo en lo que estemos centrados ahora mismo.
Nieva: ¿Por qué eligieron trabajar con Broadcom para este chip y no con Nvidia, AMD o Marvell?
Ho: Todas son muy buenas opciones. Las usaría sin dudarlo. Con Broadcom en particular, realizamos un proceso de evaluación de socios muy neutral. Para nosotros, los aspectos clave son algunos de los componentes analógicos [propiedad intelectual]. Cuando hablamos de un acelerador, no se trata de un solo chip. Antes, cuando hablábamos de una PC, nos referíamos a la CPU. ¿Qué tan buena era esa CPU? ¿Cuánta capacidad de procesamiento tenía? En la actualidad, con la IA, se trata de clústeres. Son supercomputadoras masivas que tienen muchísimos chips juntos, todos interconectados en un rack y en múltiples racks para formar el módulo completo que realmente da servicio a todo esto. Para ello, se necesita mucha comunicación. Se necesita mucha memoria muy avanzada: memoria que básicamente permite almacenar los datos, acceder a ellos muy rápidamente y luego poder obtener gran cantidad de esos datos muy rápidamente.
Nieva: ¿Entonces la propiedad intelectual de Broadcom se adaptaba mejor a sus necesidades que, por ejemplo, la de Nvidia?
Ho: Existe esa propiedad intelectual disponible de otros proveedores. Creo que acabamos de evaluarla y, en general, Broadcom fue una muy buena opción para nosotros. Además, tenemos experiencia con ellos. Mi equipo y yo venimos de Google. Estuve allí [cuando se construyó] la primera TPU. Muchos de los miembros de mi equipo provienen de ese equipo original de la TPU. Al diseñar la TPU, pasamos mucho tiempo trabajando con Broadcom. Así que es el mismo grupo de personas. Si queríamos llevar a cabo este proyecto muy rápido, eso facilitó un poco las cosas.
Nieva: Mencionaste que un factor clave en la fabricación del chip fue la rentabilidad. Obviamente, las máquinas de Nvidia son caras. ¿Esto reduce tu dependencia de Nvidia?
Ho: Creo que Nvidia seguirá formando parte de la flota. Lo principal aquí es que Sam vio la visión de la computación para OpenAI. Tenemos una gran demanda de más capacidad de procesamiento, así que esto la complementará. Por lo tanto, seguimos siendo un socio muy importante de Nvidia. Tenemos contratos con AMD, con Cerebras, con muchas empresas. ¿Dónde encaja Jalapeno en todo esto? Está añadiendo más capacidad.
Nieva: ¿Cómo gestionaste la relación con Nvidia, pasando de ser cliente a ser también fabricante de chips?
Ho: Desde mi punto de vista —y no estoy seguro de que Jensen Huang, el CEO, o Nvidia lo vean así— estamos compitiendo entre amigos. Les estamos generando muchos negocios y son una parte fundamental de nosotros. Pero si podemos hacerlo mejor e incentivarlos a que lo hagan, deberíamos hacerlo, ¿no? Y eso es lo que estamos diciendo. Nosotros lo tenemos. Ustedes pueden hacerlo mejor. Y si lo hacen mejor, nos beneficiamos. Así que todo bien. Diría que había mucho escepticismo en la industria en general sobre un chip de primera generación de un laboratorio de IA, sobre si podría estar listo para la producción, así que estoy muy orgulloso del equipo. Estoy orgulloso del apoyo que recibimos dentro de OpenAI para poder hacerlo.
Nieva: ¿Tienes alguna estimación de cuánto dinero ahorrará OpenAI en la próxima década gracias a esto?
Ho: No he realizado ese análisis. Lo siento. Quizás podamos responderle más adelante. Me resulta más difícil calcularlo en tiempo real. [En un correo electrónico posterior, un portavoz de OpenAI indicó que la empresa no dispone de una estimación.]
Nieva: ¿Cuál es la mayor diferencia entre diseñar chips para Google y para OpenAI?
Ho: Tuve el gran privilegio de estar allí y ver crecer [la TPU]. Creo que la principal diferencia que veo es la estrecha relación que mantenemos con los investigadores y el equipo de software, ya que es una empresa mucho más pequeña. Al ser una empresa pequeña, todavía estamos en modo startup. Ese nivel de interacción y de intercambio intelectual es asombroso. Y tener esa visión de alto nivel de que realmente necesitamos hacer esto —es fundamental para la empresa contar con una infraestructura sólida, algo que viene de Sam y [el cofundador y presidente de OpenAI] Greg Brockman— ha impulsado a todos a trabajar de forma tan coordinada y a ir muy rápido.
Nieva: Jalapeño es un chip de inferencia. ¿Harías un chip de entrenamiento?
Ho: El entrenamiento es fundamental. Seamos realistas, requiere mucha capacidad de procesamiento. Pero el crecimiento que observamos se da en la inferencia, y ahí es donde vemos una brecha. Por lo tanto, reducir el costo de la inferencia beneficia a toda nuestra cartera de productos. En eso nos estamos enfocando ahora.
En lo que respecta a la formación previa, no lo descarto. Es una cuestión de prioridades y de priorizar lo que es más importante para la empresa y para nuestros usuarios, para luego abordar otros aspectos. Así que no lo descartaría, pero ahora mismo no estoy centrado en ello.
Nieva: OpenAI ha dicho que comenzará a implementar Jalapeno en los centros de datos a finales de año. ¿Cuándo se utilizará en producción a gran escala?
Ho: Nuestra intención es tener algo en producción en la primera mitad de 2027. Así que algunos usuarios de ciertos modelos podrían estar usando Jalapeño para entonces. Ese es nuestro objetivo. Es un objetivo ambicioso porque hay mucho trabajo de software y muchos otros preparativos en marcha.
Nieva: ¿Cuántos gigavatios?
Ho: No creo que lo hayamos compartido públicamente.
Nieva: Se ha hablado mucho sobre el pesimismo y las ralentizaciones. Me intriga saber cómo influye esto en tu trabajo. Si hay una ralentización en el desarrollo, ¿afecta a tu forma de diseñar chips y construir centros de datos?
Ho: Este es un punto crucial. Creo que la discusión es sumamente importante en general, y la empresa está muy enfocada en asegurar que contemos con las directrices adecuadas, las medidas de seguridad necesarias y todo el monitoreo que requerimos. Esto es absolutamente fundamental. Y, por cierto, esto requiere mucha capacidad de procesamiento. La forma de verlo es que la infraestructura permite a las personas tomar estas decisiones. Se puede optar por usar parte de la capacidad de procesamiento para mayor seguridad, más medidas de protección, más monitoreo y demás. O se puede usar para mejorar los modelos. Creo que este equilibrio se establece a nivel de políticas de la empresa.
Desde nuestro punto de vista, la infraestructura debe seguir mejorando su eficiencia y su crecimiento. Considero que esto implica ampliar considerablemente lo que creíamos necesario. Pensábamos que necesitábamos una cierta capacidad de procesamiento solo para atender a los usuarios. Y si vamos a implementar muchas más medidas de seguridad y un mayor monitoreo, entonces, ¿por qué no añadir mucha más capacidad de procesamiento para ello?
Este artículo fue publicado originalmente por Forbes US.
Le puede interesar también: ¿De qué IA está usted hablando y utilizando?